(Radar) 15. 트랙 개시와 관리 — 플롯 두 개로 트랙을 만들고 점수로 상태를 바꾸기
플롯 메시지를 받아 트랙을 만들고 지우는 과정 — 신호처리와 데이터 처리를 나누는 송신·수신 쓰레드와 플롯 메시지의 구성, 1-Point 와 2-Point 개시, 두 플롯으로 초기 상태와 오차 공분산을 채우는 식, 거리·각도 표준편차를 VC-NED 공분산으로 바꾸는 R 계산, 속도 게이트, 네 가지 트랙 상태와 M/N·스코어 관리 규칙, 116 초 동안 트랙 355 개가 생기고 지워진 결과, 그리고 게이트 통과율·2-Point 속도 오차·초기 공분산의 일관성·확정 확률을 숫자로 따져 본 것까지.
이번 장에서는 트랙 개시(track initiation)와 트랙 관리(track management)를 다루겠다. 14장에서 만든 플롯은 스캔마다 쏟아지는 점일 뿐이다. 어느 점이 표적이고 어느 점이 클러터인지, 이번 스캔의 어느 점이 앞 스캔의 어느 점과 같은 물체인지 플롯 자체는 말해 주지 않는다. 이번에는 그 점들을 받아 트랙을 처음 만들고, 만든 트랙을 믿을지 지울지 스캔마다 판정하는 부분을 구현해 보겠다.
조건은 이렇게 잡았다. 트랙 개시는 연속한 두 스캔의 플롯으로 하는 2-Point 방식이고, 두 플롯을 짝지을 때 최대 속도 800 m/s 의 속도 게이트를 쓴다. 상태 변수는 축마다 위치·속도·가속도를 두어 모두 아홉이며 가속도 항은 0 으로 둔다. 초기 오차 공분산에 쓰는 측정잡음 표준편차는 거리 10 m, 방위각 0.2°, 고각 0.2° 다. 트랙 관리는 스코어 방식으로, 임시 트랙은 점수 5 에서 확정되고 0 에서 삭제되며 메모리 트랙은 메모리 점수 5 에서 삭제된다. 트랙 ID 는 100 부터 10000, 플롯 ID 는 10000 부터 1000000 사이에서 붙인다. 플롯은 안테나 구좌표 성분으로 메시지에 담아 UDP 로 데이터 처리 쓰레드에 보낸다. 트랙 연관과 추적 필터는 이번 구현의 범위 밖이라 연관 결과를 뜻하는 Assigned_Flag 는 매 스캔 실패인 0 으로 둔다.
시뮬레이션 시나리오는 13장의 지그재그 응용 시나리오를 바탕으로 하되 두 가지가 다르다. 기동 시각은 60 초로 줄이기 전의 원본 간격 그대로 두어 전체 길이가 116 초, 1 160 스캔이고, 대공 표적의 선회는 8 G 가 아니라 4 G 다. 대공 표적의 고도는 3D 화면에서 대함 표적과 구분되도록 300 m 에서 2 000 m 로 올렸다. 플랫폼은 북위 32°, 동경 126° 에 정지해 북쪽을 보고, 대함 표적은 30 m/s 로 1 G 선회 45° 를 네 번(28.4, 41.4, 72.2, 85.2 초 시작, 각 2.4 초), 대공 표적은 200 m/s 로 4 G 선회 90° 를 다섯 번(6.0, 24.1, 35.2, 67.5, 78.5 초 시작, 각 8.0 초)과 150° 를 한 번(102.6 ~ 116.0 초) 한다. 측정은 SNR 20 에 스캔당 클러터 다섯 개다.
1. 플롯에서 트랙으로
플롯(plot)은 한 스캔에서 탐지된 측정치 하나다. 거리·방위각·고각과 잰 시각을 가지지만 표적인지 클러터인지는 모른다. 트랙(track)은 같은 물체에서 나왔다고 판단한 플롯들을 시간 순서로 묶은 것이고, 번호와 위치·속도 추정값과 상태를 가진다. 플롯을 트랙으로 바꾸는 일은 세 부분으로 나뉜다. 트랙을 처음 만드는 개시, 이미 있는 트랙에 이번 스캔의 플롯을 이어 붙이는 연관(association), 그리고 트랙을 계속 믿을지 지울지 정하는 관리다. 여기서 구현한 것은 개시와 관리다.
 그림 1. 위는 궤적 모의부터 추적까지의 흐름이고, 아래는 한 프로그램 안에서 신호처리 역할과 데이터 처리 역할을 나눈 두 쓰레드다. 받는 쪽은 표적과 클러터를 구분할 정보를 받지 못한다.
프로그램을 두 쓰레드로 나눈 것은 실제 체계의 구조를 따른 것이다. 실제 레이다에서 플롯을 뽑는 신호처리기와 트랙을 만드는 데이터 처리기는 다른 장비이거나 다른 프로세스고, 둘 사이는 메시지로 이어진다. 그래서 측정 모의가 만든 플롯을 바로 트랙 함수에 넘기지 않고, 송신 쓰레드가 메시지로 묶어 UDP 로 보내고 수신 쓰레드가 받아 처리하게 했다. 받는 쪽이 보는 것은 메시지에 실린 값뿐이라, 플롯이 어느 표적에서 나왔는지는 받는 쪽 코드 어디에서도 쓸 수 없다. 화면에서 트랙 옆에 표적 번호를 보여 주는 것은 송신 쪽이 따로 적어 둔 기록을 화면이 꺼내 보는 것이다.
2. 플롯 메시지와 두 쓰레드
메시지 하나가 스캔 하나다. 머리에는 메시지 번호와 크기, 스캔 번호, 시각, 플롯 수, 측정잡음 표준편차 세 개, 플랫폼의 위치와 자세가 들어가고, 그 뒤에 플롯이 개수만큼 이어진다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
typedef struct STRUCT_PlotMsg
{
	UINT32					MsgId;				// IDD_MSG_ID_PLOT 또는 IDD_MSG_ID_END
	UINT32					MsgSize;			// 보내는 바이트 수
	UINT32					ScanNum;			// 스캔 번호
	UINT32					TimeStamp_s;		// 스캔 시각 (초)
	UINT32					TimeStamp_ns;		// 스캔 시각 (나노초)
	UINT32					PlotNum;			// 표적 플롯 + 클러터 수
	FLOAT32					Sigma_Range;		// R 표준편차: 거리 [m]
	FLOAT32					Sigma_Azimuth;		// 방위각 [rad]
	FLOAT32					Sigma_Elevation;	// 고각 [rad]
	STRUCT_PlatformInfo		st_Platform;		// 레이다 (플랫폼) 위치 · 자세
	STRUCT_PlotInfo			st_Plot[IDD_MAX_PLOT];	// PlotNum 개만 보냄
}STRUCT_PlotMsg;
플롯 하나에는 ID, 드웰·스캔·빔 번호, 시각, 빔 종류, 안테나 기준 거리·방위각·고각, 그리고 받는 쪽이 채울 직교 좌표 칸이 있다. 보내는 쪽은 ID 와 구좌표만 채운다. 구조체는 1 바이트 정렬이라 머리가 72 바이트, 플롯 하나가 121 바이트고, 표적 둘과 클러터 다섯이 든 메시지는 919 바이트다. 배열은 64 개까지 잡아 두되 실제로는 플롯 수만큼만 보낸다.
플롯마다 시각 칸이 따로 있는 것은 실제 레이다에서 한 스캔의 플롯이 같은 시각에 나오지 않기 때문이다. 회전 안테나는 스캔 주기 안에 방위각 순서로, 위상배열은 빔 일정 순서로 재므로 플롯의 시각은 메시지 시각과 최대 한 스캔 주기까지 다르다. 이 모의는 한 스캔을 한 시각으로 두어 모든 플롯에 스캔 시각을 넣었다. 실무의 플롯 메시지에 거의 늘 들어가는데 여기에는 없는 칸이 둘 있다. 플롯의 SNR 또는 진폭과 도플러로 잰 시선 속도다. 두 플롯의 거리 차를 $T$ 로 나눈 시선 속도의 표준편차는 $\sqrt 2\,\sigma_r/T$ 로 거리 잡음 4.74 m 에서 67 m/s, 10 m 에서 141 m/s 인데, 도플러는 한 번의 드웰로 시선 속도를 그보다 훨씬 정밀하게 준다. 그 값이 있으면 쌍을 고를 때 두 플롯의 위치 차로 계산한 시선 속도와 각 플롯이 보고한 도플러가 맞는지 한 번 더 검사해 클러터 쌍을 거의 다 걸러 낼 수 있고, 초기 속도의 시선 방향 성분은 위치 차 대신 도플러로 채울 수 있다. SNR 은 플롯마다 다른 측정 정확도를 받는 쪽이 계산하는 근거가 된다. 메시지에 칸이 있으면 받는 쪽이 쓸지 말지를 정할 수 있지만, 없으면 뒤에서 어떤 방법도 쓸 수 없다.
 그림 2. 머리는 고정 길이고 플롯은 개수만큼 이어진다. 보내는 쪽이 채우는 칸은 플롯 ID 와 안테나 기준 구좌표뿐이다.
메시지에 측정잡음 표준편차를 실은 것은 받는 쪽이 플롯을 만든 잡음을 알 길이 없기 때문이다. 플롯을 만든 쪽은 SNR 로 계산한 표준편차를 알지만 그것은 보내는 쪽 사정이다. 받는 쪽은 레이다가 알려 주는 정확도로 공분산을 만들어야 하고, 그 자리가 머리의 표준편차 세 칸이다. 여기서는 처음에 정한 10 m, 0.2°, 0.2° 를 실었다.
송신 쓰레드는 스캔마다 표적 플롯과 클러터를 모아 방위각 오름차순으로 섞고, 플롯 ID 를 10000 부터 차례로 붙여 메시지를 만든 뒤 127.0.0.1 의 50505 번 포트로 보낸다. 방위각 순으로 섞는 것은 실제 레이다가 빔을 도는 순서대로 플롯을 내보내기 때문이고, 그 결과 표적 플롯과 클러터가 메시지 안에서 섞인다. 모든 스캔을 보낸 뒤에는 플롯이 없는 끝 메시지를 하나 더 보낸다.
수신 쓰레드는 메시지를 받을 때마다 머리를 검사하고, 플롯마다 구좌표를 안테나 직교 좌표, 동체 좌표, VC-NED 좌표로 차례로 바꾼다. 변환은 12장의 함수를 그대로 쓴다. 좌표를 바꾼 뒤 플롯마다 측정잡음 공분산을 계산하고 트랙 처리에 넘긴다. 처리 결과는 스캔마다 버퍼에 쌓이고, 화면은 그 버퍼에서 스캔을 꺼내 그린다.
UDP 는 받는 쪽 버퍼가 차면 소리 없이 버린다. 루프백이라도 송신이 수신보다 빠르면 손실이 난다. 그래서 수신 소켓 버퍼를 8 MB 로 키우고, 처리되지 않은 메시지가 32 개 이상 쌓이면 송신이 기다리게 했다. 받는 쪽은 스캔 번호가 건너뛰면 그만큼을 손실로 센다. 1 160 스캔을 보내고 받는 동안 손실은 0 이었다. 스캔이 하나 빠지면 다음 메시지의 플롯과 앞 후보의 시각 차가 0.2 초가 되어 게이트가 160 m 로 넓어지고 속도도 그 시간 차로 나눈다. 스캔 번호가 아니라 시각으로 계산하므로 손실이 나도 식은 그대로 맞는다.
송신 간격은 화면에서 0 ms, 10 ms, 100 ms 가운데 고른다. 100 ms 가 스캔 간격과 같은 실시간이고, 0 ms 는 보내는 쪽이 쉬지 않고 보내 받는 쪽의 처리 속도와 흐름 제어를 시험하는 설정이다. 다음 송신 시각을 시작 시각에 스캔 번호 곱하기 간격으로 정하므로 한 번 늦어져도 뒤로 밀리지 않는다. 플롯은 송신 전에 모두 만들어져 있고 처리는 메시지 내용에만 의존하므로, 손실이 없는 한 간격을 바꿔도 트랙 결과는 같다. 아래 결과는 0 ms 로 돌린 것이다.
송신이 기다리는 방법은 두 쓰레드가 한 프로세스 안에서 같은 카운터를 보기 때문에 가능한 것이고, 신호처리기와 데이터 처리기가 다른 장비인 실제 체계에서는 쓸 수 없다. 거기서는 손실을 막는 대신 손실을 감지하고 견디는 쪽으로 설계한다. 메시지마다 번호를 붙여 받는 쪽이 빠진 번호를 세고, 늦게 도착하거나 순서가 바뀐 메시지는 시각을 보고 버릴지 끼워 넣을지 정한다. 지금 구현은 스캔 번호가 거꾸로 가면 잘못된 메시지로 버리는데, 루프백에서는 순서가 바뀌지 않아 문제가 없지만 네트워크에서는 정상 메시지를 버리게 된다. 한 스캔의 플롯이 한 메시지에 다 들어간다는 가정도 모의의 것이다. 실제 레이다는 섹터나 빔 단위로 플롯을 내보내므로 한 스캔이 여러 메시지로 나뉘고, 받는 쪽은 스캔 번호와 시각으로 묶어 처리하거나 메시지 단위로 바로 처리한다. 송신이 끝났음을 알리는 메시지 대신 주기적인 상태 메시지로 상대가 살아 있는지 확인하는 것도 실제 ICD 에 들어가는 항목이다.
3. 2-Point 개시
트랙을 플롯 하나로 시작할지 둘로 시작할지가 1-Point 와 2-Point 의 차이다. 플롯 하나로 만들면 위치는 바로 알지만 속도는 모르므로 0 으로 둘 수밖에 없다. 개시는 가장 빠르지만 초기 속도 오차가 크다. 연속한 두 스캔의 플롯으로 만들면 위치 차를 시간 차로 나눠 속도를 얻는다. 두 플롯 사이 시간이 측정 잡음에 비해 충분히 길면 이 속도가 0 으로 두는 것보다 낫고, 짧으면 오히려 나쁘다. 어느 쪽인지는 9절에서 숫자로 본다. 두 번째 스캔까지 기다려야 하므로 개시는 한 스캔 늦다.
 그림 3. 왼쪽은 두 개시 방법의 차이다. 오른쪽은 앞 스캔 플롯마다 게이트를 두고 이번 스캔 플롯과 짝짓는 모양으로, 게이트 밖의 쌍은 버리고 짝이 없는 플롯은 다음 스캔의 후보로 남긴다.
상태 변수는 축마다 위치·속도·가속도를 가지는 아홉 개로 두었다. 좌표계는 레이다를 원점으로 하는 북·동·아래 방향의 VC-NED 다.
\[X_k = \begin{bmatrix} x & \dot x & \ddot x & y & \dot y & \ddot y & z & \dot z & \ddot z \end{bmatrix}^T\]앞 스캔 플롯을 $z_{k-1}$, 이번 스캔 플롯을 $z_k$, 두 스캔의 시간 차를 $T$ 라 하면 축마다 같은 식으로 초기 상태를 채운다. 위치는 이번 플롯, 속도는 위치 차를 시간 차로 나눈 값, 가속도는 0 이다.
\[\hat x = z_k, \qquad \hat{\dot x} = \frac{z_k - z_{k-1}}{T}, \qquad \hat{\ddot x} = 0\]초기 오차 공분산은 플롯의 측정잡음 공분산 $R$ 로 만든다. 위치의 오차는 이번 플롯의 오차 그대로다. 속도는 두 플롯의 차를 $T$ 로 나눈 것이므로 분산은 두 플롯의 분산을 더해 $T^2$ 으로 나눈 값이고, 위치와 속도는 이번 플롯 $z_k$ 를 함께 쓰므로 공분산이 $R_k / T$ 로 남는다.
\[P_{pp} = R_k, \qquad P_{pv} = P_{vp} = \frac{R_k}{T}, \qquad P_{vv} = \frac{R_k + R_{k-1}}{T^2}\]$R$ 이 3 × 3 이므로 이 식은 축 사이의 칸도 함께 채운다. 가속도 행과 열은 모두 0 이다.
 그림 4. 행과 열을 x, ẋ, ẍ, y, ẏ, ÿ, z, ż, z̈ 순서로 놓은 9 × 9 다. 같은 색 칸이 같은 식이고, R 의 (a, b) 성분이 축 a 와 축 b 가 만나는 블록에 들어가므로 축 사이 칸도 비어 있지 않다. 가속도 행과 열은 0 이다.
가속도 행과 열은 0 으로 두기로 했지만 그 뜻은 적어 두어야 한다. 공분산 0 은 가속도가 정확히 0 이라고 확신한다는 선언이다. 이 $P$ 는 행렬식이 0 인 특이 행렬이라 역행렬이 없고, 뒤에 올 추적 필터가 등가속도 모델이면 칼만 이득의 가속도 행이 $P_{ap} S^{-1} = 0$ 이라 측정이 들어와도 가속도 추정값이 움직이지 않는다. 가속도는 공정 잡음 $Q$ 가 예측 단계에서 분산을 넣어 준 뒤에야 조금씩 배워진다. 이 시나리오의 대공 표적은 4 G 로 선회하며 가속도가 39 m/s² 이고 1 초에 속도 벡터가 39 m/s 바뀐다. 실제 체계에서는 표적이 낼 수 있는 최대 가속도 $a_{max}$ 를 정해 가속도 칸에 $a_{max}^2/3$ 을 넣는다. 가속도가 $\pm a_{max}$ 사이에 고르게 있다고 본 분산이고, 3 g 면 표준편차 17 m/s², 4 g 면 23 m/s² 다. 등속 6 상태 필터를 쓸 것이면 가속도 행과 열을 아예 빼는 쪽이 특이 행렬을 들고 다니는 것보다 낫다.
코드는 세 축을 돌며 위 식을 그대로 옮긴다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
VOID f_Trk_TwoPointInit(ST_Track *st_Track, const ST_TrkPlot *st_Prev, const ST_TrkPlot *st_Cur)
{
	const FLOAT64	dt = st_Cur->time - st_Prev->time;
	matrix			*st_X = &st_Track->mat_EstX;
	matrix			*st_P = &st_Track->mat_EstP;
	INT32			nAxis;
	INT32			nAxisB;

	Matrix_initialize(st_X, TRK_STATE_DIM, 1);
	Matrix_initialize(st_P, TRK_STATE_DIM, TRK_STATE_DIM);

	for (nAxis = 0; nAxis < 3; nAxis++)
	{
		st_X->e[(3 * nAxis)][0]		= st_Cur->pos[nAxis];
		st_X->e[(3 * nAxis) + 1][0]	= (st_Cur->pos[nAxis] - st_Prev->pos[nAxis]) / dt;
		st_X->e[(3 * nAxis) + 2][0]	= 0.0;

		for (nAxisB = 0; nAxisB < 3; nAxisB++)
		{
			st_P->e[(3 * nAxis)][(3 * nAxisB)]			= st_Cur->cov[nAxis][nAxisB];
			st_P->e[(3 * nAxis)][(3 * nAxisB) + 1]		= st_Cur->cov[nAxis][nAxisB] / dt;
			st_P->e[(3 * nAxis) + 1][(3 * nAxisB)]		= st_Cur->cov[nAxis][nAxisB] / dt;
			st_P->e[(3 * nAxis) + 1][(3 * nAxisB) + 1]	= (st_Cur->cov[nAxis][nAxisB] + st_Prev->cov[nAxis][nAxisB]) / (dt * dt);
		}
	}
}
처음 만들어진 트랙 100 을 보면 식이 어떻게 숫자가 되는지 보인다. 이 트랙은 스캔 10 에 대공 표적의 플롯 둘로 개시됐고, 레이다에서 13.26 km, 고각 8.7° 에 있었다. 초기 위치 표준편차는 북 12.1 m, 동 45.8 m, 아래 45.8 m 다. 가로 방향인 동쪽과 아래쪽은 13.26 km 에 0.2° 를 곱한 46.3 m 에 고각의 코사인이 곱해진 값이다. 거리 방향인 북쪽은 거리 표준편차 10 m 에 고각 8.7° 때문에 북쪽으로 섞여 든 고각 오차 성분 7.0 m, 곧 46.3 m × sin 8.7° 가 직교로 더해져 12.1 m 다. 속도 표준편차는 북 171 m/s, 동 648 m/s, 아래 648 m/s 로, 두 플롯의 공분산을 더해 0.1 초의 제곱으로 나눈 값이다. 위치 표준편차에 $\sqrt 2$ 를 곱하고 0.1 초로 나눈 것과 거의 같다. 두 플롯이 각각 46 m 씩 흔들리는데 그 차를 0.1 초로 나누니 속도는 수백 m/s 가 흔들린다. 이 숫자의 뜻은 9절에서 다시 본다.
4. 측정잡음 공분산 R
초기 공분산을 만들려면 플롯 하나의 위치 오차를 VC-NED 축의 3 × 3 행렬로 적어야 한다. 레이다가 재는 것은 거리·방위각·고각이고 오차의 표준편차도 그 성분으로 주어지므로, 세 성분의 오차가 북·동·아래 위치의 오차로 어떻게 바뀌는지를 따라가면 된다.
거리 오차는 어디서나 10 m 다. 각도 오차는 거리에 곱해져 위치 오차가 되므로 멀수록 커진다. 0.2° 는 5 km 에서 17 m, 14 km 에서 49 m 다. 그래서 같은 표적을 여러 번 재면 플롯은 시선 방향으로는 좁고 그에 수직한 방향으로는 넓은 타원 모양으로 흩어진다.
 그림 5. 시선 방향 오차는 거리와 무관하고 가로 방향 오차는 거리에 비례한다. 같은 표적을 반복해 재면 플롯이 이 타원 모양으로 흩어지고, 그 흩어짐을 행렬로 적은 것이 R 이다.
계산은 세 단계다. 먼저 재는 값의 오차를 대각 행렬 $S = \mathrm{diag}(\sigma_r^2, \sigma_{az}^2, \sigma_{el}^2)$ 로 놓는다. 세 오차는 서로 따로 생기므로 대각선 밖은 0 이다. 다음으로 구좌표가 조금 변할 때 안테나 직교 좌표가 얼마나 움직이는지를 적은 기울기 행렬 $J$ 를 곱한다. 안테나 좌표는 $x = r\cos el \sin az$, $y = r \sin el$, $z = r \cos el \cos az$ 이고, 이것을 $r$, $az$, $el$ 로 미분한 것이 $J$ 다.
\[J = \begin{bmatrix} \cos el \sin az & r \cos el \cos az & -r \sin el \sin az \\ \sin el & 0 & r \cos el \\ \cos el \cos az & -r \cos el \sin az & -r \sin el \cos az \end{bmatrix}\]세 열의 크기가 각각 1, $r \cos el$, $r$ 이다. 각도 오차에 거리가 곱해져 미터 오차가 되는 것이 이 열에서 나온다. 마지막으로 안테나 축을 동체 축으로, 동체 축을 플랫폼 자세에 따라 북·동·아래로 돌리는 회전 $M$ 을 곱한다. 회전은 방향만 바꾸므로 오차의 크기는 그대로다.
\[R = M\,J\,S\,J^T\,M^T\]$J$ 와 $M$ 을 앞뒤로 두 번 곱하는 것은 공분산이 오차와 오차의 전치를 곱한 것이기 때문이다. 오차 $e$ 를 행렬 $A$ 로 바꾸면 공분산은 $A R A^T$ 가 된다. 플롯마다 거리와 방향이 다르므로 $R$ 은 플롯마다 계산한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
VOID f_Trk_MeasCov(FLOAT64 cov[3][3], const STRUCT_Coord_Sph *st_Meas, const STRUCT_Coord_Sph *st_Sigma, const STRUCT_Coord_Attitude *st_Att)
{
	const FLOAT64		r = st_Meas->r;
	const FLOAT64		cosAz = cos(st_Meas->az);
	const FLOAT64		sinAz = sin(st_Meas->az);
	const FLOAT64		cosEl = cos(st_Meas->el);
	const FLOAT64		sinEl = sin(st_Meas->el);
	STRUCT_Coord_Rect	st_Body;
	STRUCT_Coord_Rect	st_Ned;
	matrix				mat_J, mat_Jt, mat_S, mat_Ra, mat_M, mat_Mt, mat_R;
	FLOAT64				axis[3];
	INT32				nRow;
	INT32				nCol;

	// x = r cos(el) sin(az), y = r sin(el), z = r cos(el) cos(az) 를 r, az, el 로 미분
	Matrix_initialize(&mat_J, 3, 3);
	mat_J.e[0][0] = cosEl * sinAz;	mat_J.e[0][1] = r * cosEl * cosAz;		mat_J.e[0][2] = -r * sinEl * sinAz;
	mat_J.e[1][0] = sinEl;			mat_J.e[1][1] = 0.0;					mat_J.e[1][2] = r * cosEl;
	mat_J.e[2][0] = cosEl * cosAz;	mat_J.e[2][1] = -r * cosEl * sinAz;	mat_J.e[2][2] = -r * sinEl * cosAz;

	Matrix_initialize(&mat_S, 3, 3);
	mat_S.e[0][0] = st_Sigma->r * st_Sigma->r;
	mat_S.e[1][1] = st_Sigma->az * st_Sigma->az;
	mat_S.e[2][2] = st_Sigma->el * st_Sigma->el;

	mat_Jt = Matrix_Transpose(&mat_J);
	mat_Ra = Matrix_Product3(&mat_J, &mat_S, &mat_Jt);

	// 회전 M 의 열 = 안테나 축 단위 벡터를 동체, NED 로 옮긴 것
	Matrix_initialize(&mat_M, 3, 3);

	for (nCol = 0; nCol < 3; nCol++)
	{
		axis[0]	= (nCol == 0) ? 1.0 : 0.0;
		axis[1]	= (nCol == 1) ? 1.0 : 0.0;
		axis[2]	= (nCol == 2) ? 1.0 : 0.0;
		st_Body	= f_Trans_Ant_To_Body(axis[0], axis[1], axis[2]);
		st_Ned	= f_Trans_Body_To_Ned(st_Body.x, st_Body.y, st_Body.z, st_Att->Roll, st_Att->Yaw, st_Att->Pitch);
		mat_M.e[0][nCol] = st_Ned.x;
		mat_M.e[1][nCol] = st_Ned.y;
		mat_M.e[2][nCol] = st_Ned.z;
	}

	mat_Mt	= Matrix_Transpose(&mat_M);
	mat_R	= Matrix_Product3(&mat_M, &mat_Ra, &mat_Mt);

	// 반올림으로 생긴 작은 비대칭 제거
	for (nRow = 0; nRow < 3; nRow++)
	{
		for (nCol = 0; nCol < 3; nCol++)
		{
			cov[nRow][nCol] = 0.5 * (mat_R.e[nRow][nCol] + mat_R.e[nCol][nRow]);
		}
	}
}
회전 $M$ 은 따로 식을 적지 않고 좌표 변환 함수에 단위 벡터를 넣어 열을 하나씩 얻는다. 변환 함수가 이미 검증돼 있으므로 같은 회전을 두 번 적을 이유가 없다. 이번 시나리오는 플랫폼이 북쪽을 보고 정지해 있어 동체에서 NED 로 가는 회전은 단위 행렬이다.
플롯을 만들 때 넣은 잡음은 SNR 20 으로 계산한 거리 4.74 m, 방위각 0.4781°, 고각 0.4939° 였다. 트랙 초기화에 쓰는 표준편차는 따로 정해 둔 10 m, 0.2°, 0.2° 다. 둘은 역할이 다르다. 앞의 것은 플롯을 만드는 쪽이 실제로 넣은 잡음이고, 뒤의 것은 받는 쪽이 메시지로 전달받아 공분산을 만드는 데 쓰는 값이다. 두 값이 다를 때 무슨 일이 생기는지는 9절에서 숫자로 본다.
5. 속도 게이트
앞 스캔의 플롯과 이번 스캔의 플롯을 아무렇게나 짝지으면 클러터끼리도 트랙이 된다. 표적이 가질 수 있는 최대 속도로 짝을 거르는 것이 속도 게이트다. 두 플롯 사이 거리를 시간 차로 나눈 값이 최대 속도보다 작을 때만 트랙을 만든다.
\[\frac{\lvert z_{k,i} - z_{k-1,j} \rvert}{T} < V_{max}\]최대 속도 800 m/s 에 스캔 간격 $T$ = 0.1 초를 곱하면 앞 플롯을 중심으로 반경 80 m 의 구가 게이트다. 그림 3 의 오른쪽이 이 모양이다.
게이트를 지난 쌍이 여럿일 때 어떻게 고를지는 따로 규칙을 세워야 했다. 게이트를 지난 쌍 가운데 속력이 가장 작은 쌍부터 트랙으로 만들고, 한 플롯은 한 트랙에만 쓴다. 트랙을 만드는 데 쓴 플롯은 다음 스캔의 개시 후보에서 빼고, 짝이 없던 이번 스캔 플롯은 다음 스캔의 후보로 남긴다. 한 스캔에 플롯이 일곱이면 앞 스캔 후보 일곱과 짝지어 마흔아홉 쌍을 검사하는데, 116 초 동안 검사한 쌍은 54 306 개였고 그 가운데 게이트를 지난 쌍이 355 개다.
이 게이트는 표적의 최대 속도만 보고 측정 잡음은 보지 않는다. 그래서 같은 표적의 두 플롯이라도 잡음 때문에 80 m 보다 멀리 떨어지면 짝이 되지 못한다. 이것이 결과에 어떻게 나타나는지도 9절에서 본다.
6. 트랙 상태와 스코어
개시된 트랙이 모두 표적은 아니다. 그래서 트랙마다 상태를 두고, 스캔마다 연관 결과에 따라 상태를 바꾼다. 연관은 트랙의 위치와 속도로 이번 스캔의 위치를 예측하고 그 둘레의 게이트 안에서 가장 가까운 플롯을 트랙에 붙이는 과정이다. 붙일 플롯이 있으면 Assigned_Flag 가 1, 없으면 0 이다. 상태는 네 가지로 두었다. 막 개시한 임시(tentative) 트랙, 연관이 꾸준히 성공해 믿을 만해진 확정(confirmed) 트랙, 확정이었다가 이번 스캔에 놓쳐 바로 지우지 않고 기다리는 메모리(memory) 트랙, 그리고 더 볼 필요 없는 삭제(deleted) 트랙이다.
 그림 6. 트랙의 위치와 속도로 예측한 이번 스캔 위치 둘레에 연관 게이트를 둔다. 게이트 안에 플롯이 있으면 가장 가까운 것을 붙여 Assigned_Flag 가 1 이고, 없으면 0 이다.
2-Point 로 만든 트랙이 다음 스캔에서 쓰는 예측 위치는 $z_k + T\,\hat v = 2 z_k - z_{k-1}$ 이다. 이번 플롯을 두 배 하고 앞 플롯을 뺀 것이라 예측 공분산은 $4R_k + R_{k-1}$, 두 플롯의 공분산이 같으면 $5R$ 이고, 여기에 새 플롯의 $R$ 이 더해져 연관에 쓰는 혁신(innovation) 공분산은 $6R$ 이 된다. 개시 직후의 연관 게이트는 플롯 하나 잡음의 $\sqrt 6$, 약 2.45 배라는 뜻이다. 14 km 에서 실제 플롯 잡음으로는 가로 방향 표준편차가 288 m 라 3σ 가 ±860 m 이고, 초기화에 쓴 0.2° 로는 121 m, ±360 m 다. 개시에 쓴 80 m 속도 게이트와 같은 자리에서 열 배 넘게 큰 게이트가 한 스캔 뒤에 열린다.
 그림 7. 임시에서 확정으로, 확정에서 메모리로, 메모리에서 다시 확정으로 가는 전이와 삭제로 빠지는 두 전이가 있다. 전이 조건은 전부 연관 결과 하나와 점수 두 개로 적힌다.
상태를 바꾸는 규칙에는 두 가지가 있다. M/N 방식은 최근 N 번의 스캔 가운데 M 번 연관에 성공하면 확정하고, 임시 트랙이 M 번 연속 실패하면 삭제한다. 확정 트랙이 연관에 실패하면 메모리로 바꾸고, 메모리 상태가 일정 시간 이상 이어지면 삭제한다. 성공과 실패를 횟수로 세므로 규칙이 단순하지만, 트랙마다 최근 N 번의 이력을 들고 있어야 한다. N 이 5, M 이 3 일 때 개시 뒤 연관 결과가 성공·실패·성공·성공이면 최근 다섯 번 안의 성공 수는 1, 1, 2, 3 으로 늘고, 3 이 되는 네 번째 스캔에서 바로 확정된다. 다섯 번째 스캔까지 기다리지 않는다. 확정되기 전에는 스캔마다 최근 다섯 번을 다시 세므로 오래된 결과는 창 밖으로 밀려 나가고, 삭제는 연속 실패 수가 M 에 닿을 때다. 9절 그림 20 의 M/N 곡선도 이 규칙으로 계산한 것이다.
스코어 방식은 연관에 성공하면 점수를 올리고 실패하면 내린다. 임시 트랙은 TrackScore 가 확정 문턱 5 이상이 되면 확정, 삭제 문턱 0 이하가 되면 삭제한다. 확정 트랙은 실패하면 메모리로 바뀌며 MemoryScore 가 1 오른다. 메모리 트랙은 성공하면 바로 확정으로 돌아가며 MemoryScore 가 0 으로 돌아가고, 실패가 이어져 MemoryScore 가 5 이상이 되면 삭제된다. 여기서는 이 방식을 썼다. 개시 직후 점수는 2 로 두었다. 플롯 두 개로 만든 트랙이니 연관에 두 번 성공한 것으로 친 것이다.
 그림 8. 성공 세 번으로 점수 5 가 되어 확정되고, 실패 두 번에 메모리로 갔다가 성공 한 번에 바로 확정으로 돌아온다. 그 뒤 실패 다섯 번에 메모리 점수가 5 가 되어 삭제된다. 확정된 뒤로 TrackScore 는 움직이지 않는다.
코드는 상태별로 나눠 규칙을 그대로 옮겼다. 호출하기 전에 Assigned_Flag 를 채워 두고, 트랙마다 스캔에 한 번 부른다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
VOID f_Trk_UpdateState(ST_Track *st_Track)
{
	const INT32 isAssigned = (st_Track->Assigned_Flag != 0) ? 1 : 0;

	switch (st_Track->TrackState)
	{
	case TRK_STATE_TENTATIVE:
		st_Track->TrackScore = st_Track->TrackScore + ((isAssigned != 0) ? 1 : -1);

		if (st_Track->TrackScore >= TRK_SCORE_CONFIRM)
		{
			st_Track->TrackState = TRK_STATE_CONFIRMED;
		}
		else if (st_Track->TrackScore <= TRK_SCORE_DELETE)
		{
			st_Track->TrackState = TRK_STATE_DELETED;
		}
		break;

	case TRK_STATE_CONFIRMED:
		if (isAssigned == 0)
		{
			st_Track->TrackState	= TRK_STATE_MEMORY;
			st_Track->MemoryScore	= st_Track->MemoryScore + 1;
		}
		break;

	case TRK_STATE_MEMORY:
		if (isAssigned != 0)
		{
			st_Track->TrackState	= TRK_STATE_CONFIRMED;
			st_Track->MemoryScore	= 0;
		}
		else
		{
			st_Track->MemoryScore	= st_Track->MemoryScore + 1;

			if (st_Track->MemoryScore >= TRK_MEMORY_DELETE)
			{
				st_Track->TrackState = TRK_STATE_DELETED;
			}
		}
		break;

	default:
		// 삭제 트랙은 다음 스캔에 표에서 빠짐
		break;
	}
}
연관 기능이 없는 이번 시뮬레이션에서는 Assigned_Flag 가 늘 0 이라 모든 트랙이 임시에서 삭제로만 간다. 개시 점수 2 가 다음 스캔에 1, 그다음 스캔에 0 이 되어 삭제 상태가 되고, 그다음 스캔의 처리를 시작할 때 표에서 빠진다. 확정과 메모리로 가는 전이는 화면의 스코어 확인 창에 플래그 열을 직접 넣어 확인했다. 그 결과는 8절에 있다.
7. 구현
14장의 프로그램에 송수신과 트랙 처리를 얹었다. C 로 짠 코어 DLL 에 궤적 계산, 측정 모의, 송수신 쓰레드, 트랙 개시·관리가 들어 있고, MFC 화면은 코어가 스캔마다 쌓아 둔 결과를 꺼내 그린다. 트랙 하나와 조건 상수는 아래와 같다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
#define TRK_VMAX				800.0					// 속도 게이트 [m/s]
#define TRK_SCORE_CONFIRM		5						// TrackScore >= 5 이면 확정
#define TRK_SCORE_DELETE		0						// TrackScore <= 0 이면 삭제
#define TRK_MEMORY_DELETE		5						// MemoryScore >= 5 이면 삭제
#define TRK_SCORE_INIT			2						// 개시 점수 (두 플롯 = 성공 2 번)
#define TRK_ID_MIN				100						// 트랙 ID 범위
#define TRK_ID_MAX				10000
#define TRK_R_SIGMA_RANGE		10.0					// R 표준편차: 거리 [m]
#define TRK_R_SIGMA_AZIMUTH		0.2						// 방위각 [deg]
#define TRK_R_SIGMA_ELEVATION	0.2						// 고각 [deg]

typedef struct
{
	UINT32					TrackId;						// 100 ~ 10000
	INT32					TrackState;						// 1 임시, 2 확정, 3 메모리, 4 삭제
	INT32					TrackScore;
	INT32					MemoryScore;
	INT32					Assigned_Flag;					// 연관 결과: 1 성공, 0 실패
	matrix					mat_EstX;						// 상태변수 9 x 1 (VC-NED)
	matrix					mat_EstP;						// 오차 공분산 9 x 9
	FLOAT64					initTime;						// 개시 시각 [s]
	INT32					nInitScan;						// 개시 스캔
	UINT32					PlotId[2];						// 개시 플롯 ID (앞 스캔, 이번 스캔)
} ST_Track;
트랙 표는 256 개까지 잡아 두었다. 표가 차면 그 스캔의 남은 쌍은 트랙이 되지 못하고 못 만든 수만 센다. 실제 체계에서 이 수가 0 이 아니면 게이트나 관리 규칙이 느슨한 것이므로 요약에 함께 보이게 했고, 표가 차는 상황이라면 점수가 가장 낮은 임시 트랙을 밀어내고 새 트랙을 받는 규칙이 있어야 가짜 트랙이 표를 채워 진짜 표적의 개시를 막는 일을 피한다. 이번 실행은 표에 많아야 네 개라 그 일이 없었다. 트랙 ID 는 표에 남은 ID 만 피하므로 삭제된 ID 는 한 바퀴 뒤에 바로 다시 쓰인다. 이 속도면 9 901 개의 ID 공간이 54 분에 한 바퀴 돈다. 트랙을 받아 쓰는 전시기나 지휘통제 체계는 ID 로 트랙을 구분하고 기록하므로, 지워진 ID 가 곧바로 다른 표적에 붙으면 두 표적이 하나로 기록된다. 실제 체계는 삭제된 ID 에 일정 시간 재사용 금지를 두고 가장 오래 쉰 ID 부터 꺼내 쓴다.
수신 쓰레드가 메시지를 받을 때마다 트랙 처리 함수가 네 단계를 같은 순서로 밟는다.
 그림 9. 삭제 트랙 정리, 트랙 관리, 2-Point 개시, 후보 보관의 순서다. 개시가 관리 뒤에 오므로 새 트랙의 점수는 다음 스캔부터 움직인다.
첫째로 앞 스캔에서 삭제 상태가 된 트랙을 표에서 뺀다. 삭제 상태를 한 스캔 동안 표에 남겨 두는 것은 화면과 기록에서 그 트랙이 왜 사라졌는지 볼 수 있게 하려는 것이다. 둘째로 남은 트랙마다 Assigned_Flag 를 0 으로 두고 스코어 함수를 부른다. 셋째로 앞 스캔의 후보와 이번 스캔의 플롯을 짝지어 새 트랙을 만든다. 게이트를 지난 쌍 가운데 속력이 가장 작은 쌍을 찾아 트랙을 만들고 두 플롯을 쓴 것으로 표시한 뒤, 남은 플롯으로 다시 가장 가까운 쌍을 찾는 일을 쌍이 없을 때까지 되풀이한다. 트랙 ID 는 100 부터 차례로 붙이되 표에 있는 트랙과 겹치지 않게 하고, 10000 을 넘으면 100 으로 돌아온다. 넷째로 이번 스캔의 플롯을 다음 스캔의 개시 후보로 보관한다.
단계마다 맡은 함수는 아래와 같다. 송수신은 PlotLink.c, 트랙 계산은 TrackMgr.c 에 있다.
| 단계 | 함수 | 파일 |
|---|---|---|
| 스캔의 플롯을 방위각 순으로 모아 ID 와 R 표준편차를 실은 메시지로 만들기 | f_Lnk_BuildMsg | PlotLink.c |
| 수신이 준비되면 스캔마다 보내고, 처리가 32 개 뒤처지면 기다리기, 끝 메시지 | f_Lnk_TxThread, f_Lnk_WaitReceiver | PlotLink.c |
| 받아서 머리 검사, 건너뛴 스캔 번호를 손실로 세기 | f_Lnk_RxThread, f_Lnk_CheckMsg, f_Lnk_OnRecv | PlotLink.c |
| 구좌표를 안테나 직교·동체·VC-NED 로 바꾸기 | f_Lnk_FillPlotCoord | PlotLink.c |
| 플롯마다 측정잡음 공분산 R | f_Trk_MeasCov | TrackMgr.c |
| 플랫폼 이동만큼 앞 스캔 값을 새 원점으로 옮기기 | f_Trk_MoveOrigin | TrackMgr.c |
| 삭제 정리·스코어·2-Point 개시·후보 보관의 네 단계 | f_Trk_ProcessScan, f_Trk_UpdateState, f_Trk_TwoPointInit | TrackMgr.c |
| 처리 결과를 스캔마다 버퍼에 쌓고 화면이 꺼내 가기 | f_Lnk_ProcessMsg, f_Lnk_CopyScan | PlotLink.c |
연관이 붙으면 개시 후보의 범위가 달라진다. 지금은 이번 스캔의 플롯 전부가 개시 후보지만, 연관이 있는 체계에서는 기존 트랙에 연관된 플롯을 후보에서 빼고 연관되지 않은 플롯만으로 새 트랙을 만든다. 그러지 않으면 표적 트랙이 살아 있는 동안에도 그 표적의 연속한 두 플롯이 속도 게이트를 지날 때마다 같은 표적에 임시 트랙이 하나 더 생긴다. 이 시뮬레이션의 통과율로 치면 표적 1 에서 초당 1.2 개, 표적 2 에서 초당 2.7 개다. 연관이 성공하는 표적이므로 그 중복 트랙은 세 스캔 뒤 모두 확정된다. 처리 순서는 연관, 트랙 관리, 연관되지 않은 플롯으로 개시, 후보 보관이 되고, 한 플롯은 연관이든 개시든 한 트랙에만 쓴다는 규칙이 두 단계에 같이 걸린다. 그래도 남는 중복은 두 트랙의 위치·속도 차를 공분산의 합으로 정규화해 문턱 아래면 하나로 합치는 트랙 병합으로 정리한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
	while (isSearching != 0)
	{
		bestSpeed	= TRK_VMAX;
		bestPrev	= -1;
		bestCur		= -1;

		for (nPrev = 0; nPrev < st_Table->nPrevPlotNum; nPrev++)
		{
			for (nCur = 0; nCur < nCurNum; nCur++)
			{
				if ((st_Table->st_PrevPlot[nPrev].isUsed == 0) && (st_Cur[nCur].isUsed == 0))
				{
					speed = f_Trk_PairSpeed(&st_Table->st_PrevPlot[nPrev], &st_Cur[nCur], dt);

					if (speed < bestSpeed)
					{
						bestSpeed	= speed;
						bestPrev	= nPrev;
						bestCur		= nCur;
					}
				}
			}
		}

		if (bestPrev < 0)
		{
			isSearching = 0;
		}
		else
		{
			st_Table->st_PrevPlot[bestPrev].isUsed	= 1;
			st_Cur[bestCur].isUsed					= 1;
			// 새 트랙: f_Trk_TwoPointInit 뒤에 ID, 상태 1, 점수 2, 개시 시각과 플롯 ID 를 채운다
		}
	}
가장 작은 속력부터 고르는 탐색은 쌍의 수가 적어 매번 전체를 다시 훑어도 비용이 문제되지 않는다. 플롯이 수백 개가 되면 쌍을 속력순으로 한 번 정렬해 두고 훑는 쪽이 낫다.
플랫폼이 움직이는 경우도 처리해 두었다. VC-NED 의 원점은 플랫폼이므로 플랫폼이 움직이면 앞 스캔에서 저장한 후보 플롯과 트랙 위치를 새 원점 기준으로 옮겨야 한다. 수신 쓰레드가 앞 메시지와 이번 메시지의 플랫폼 ECEF 위치 차를 NED 로 바꿔 그만큼 빼 준다. 이번 시나리오는 플랫폼이 정지해 있어 이동량이 0 이다. 플랫폼 위치는 ICD 대로 ECEF 성분을 32 비트 실수로 싣는데, 이 위도·경도에서 ECEF 성분은 320 만 ~ 440 만 m 라 32 비트 실수의 한 눈금이 0.25 ~ 0.5 m 다. 두 메시지의 위치 차로 원점 이동량을 구하면 스캔마다 그 크기의 계단 오차가 들어가고, 10 m/s 로 움직이는 플랫폼의 한 스캔 이동량 1 m 에 견주면 작지 않다. 이 오차는 앞 스캔 후보의 위치를 틀리게 옮겨 2-Point 속도에 최대 6 m/s 로 들어간다. 플랫폼이 움직이는 체계라면 위치를 64 비트로 싣거나 앞 메시지 이후의 이동량을 따로 보내야 하고, 좌표 변환과 $R$ 의 회전에 쓰는 플랫폼 자세도 메시지 시각이 아니라 플롯 시각의 값이어야 한다. 배가 5°/s 로 롤하면 50 ms 에 0.25° 가 돌아가고 14 km 에서 61 m 라, 0.2° 의 가로 오차 49 m 보다 크다.
화면에는 2D 와 3D 보기, 트랙 수명 보기, 현재 스캔의 트랙 표, 송수신과 트랙 요약, 그리고 스코어 확인 창이 있다. 2D 는 위경도 격자 위에 참값 궤적·플롯·클러터·트랙을 함께 그리고, 3D 는 동·북·고도 축에 고도를 두 배로 늘려 그린다. 트랙 수명 보기는 트랙마다 한 줄, 스캔마다 한 칸을 그려 그 스캔을 처리한 뒤의 상태 색으로 채우고, 지금 스캔은 세로 띠로 표시해 슬라이더와 함께 움직이며, 받지 못한 스캔은 회색 바탕으로 남겨 UDP 손실이 있으면 어디서 났는지 보인다. 트랙 표는 ID, 상태, 두 점수, 플래그, 개시 스캔과 개시 플롯, 위치와 속도, 그리고 초기 공분산에서 구한 위치·속도 표준편차를 보여 준다. 이 표준편차는 세 축 표준편차의 제곱합 제곱근이고 CSV 에는 축별 값도 남긴다. 같은 결과를 CSV 로도 저장하게 해서 아래 그림 가운데 몇 장은 그 파일로 그렸다.
8. 시뮬레이션 결과
| 항목 | 값 |
|---|---|
| 시나리오 | 13장 지그재그 응용 시나리오의 원본 길이판, 116 s, 스캔 간격 0.1 s, 1 160 스캔 |
| 플랫폼 | 정지, 북쪽을 봄 |
| 표적 1 | 대함, 30 m/s, 1 G 선회, 거리 13.6 ~ 14.1 km |
| 표적 2 | 대공, 200 m/s, 4 G 선회, 고도 2 000 m, 13.5 km 에서 4.8 km 로 접근 |
| 플롯 | SNR 20, 표적 2 + 클러터 5 = 스캔당 7 개 |
| 개시 | 2-Point, 최대 속도 800 m/s, 개시 점수 2 |
| 관리 | 확정 5, 삭제 0, 메모리 삭제 5, Assigned_Flag 0 고정 |
| R 표준편차 | 10 m, 0.2°, 0.2° |
| 전송 | UDP 루프백, 보냄 = 받음 = 처리 = 1 160, 손실 0 |
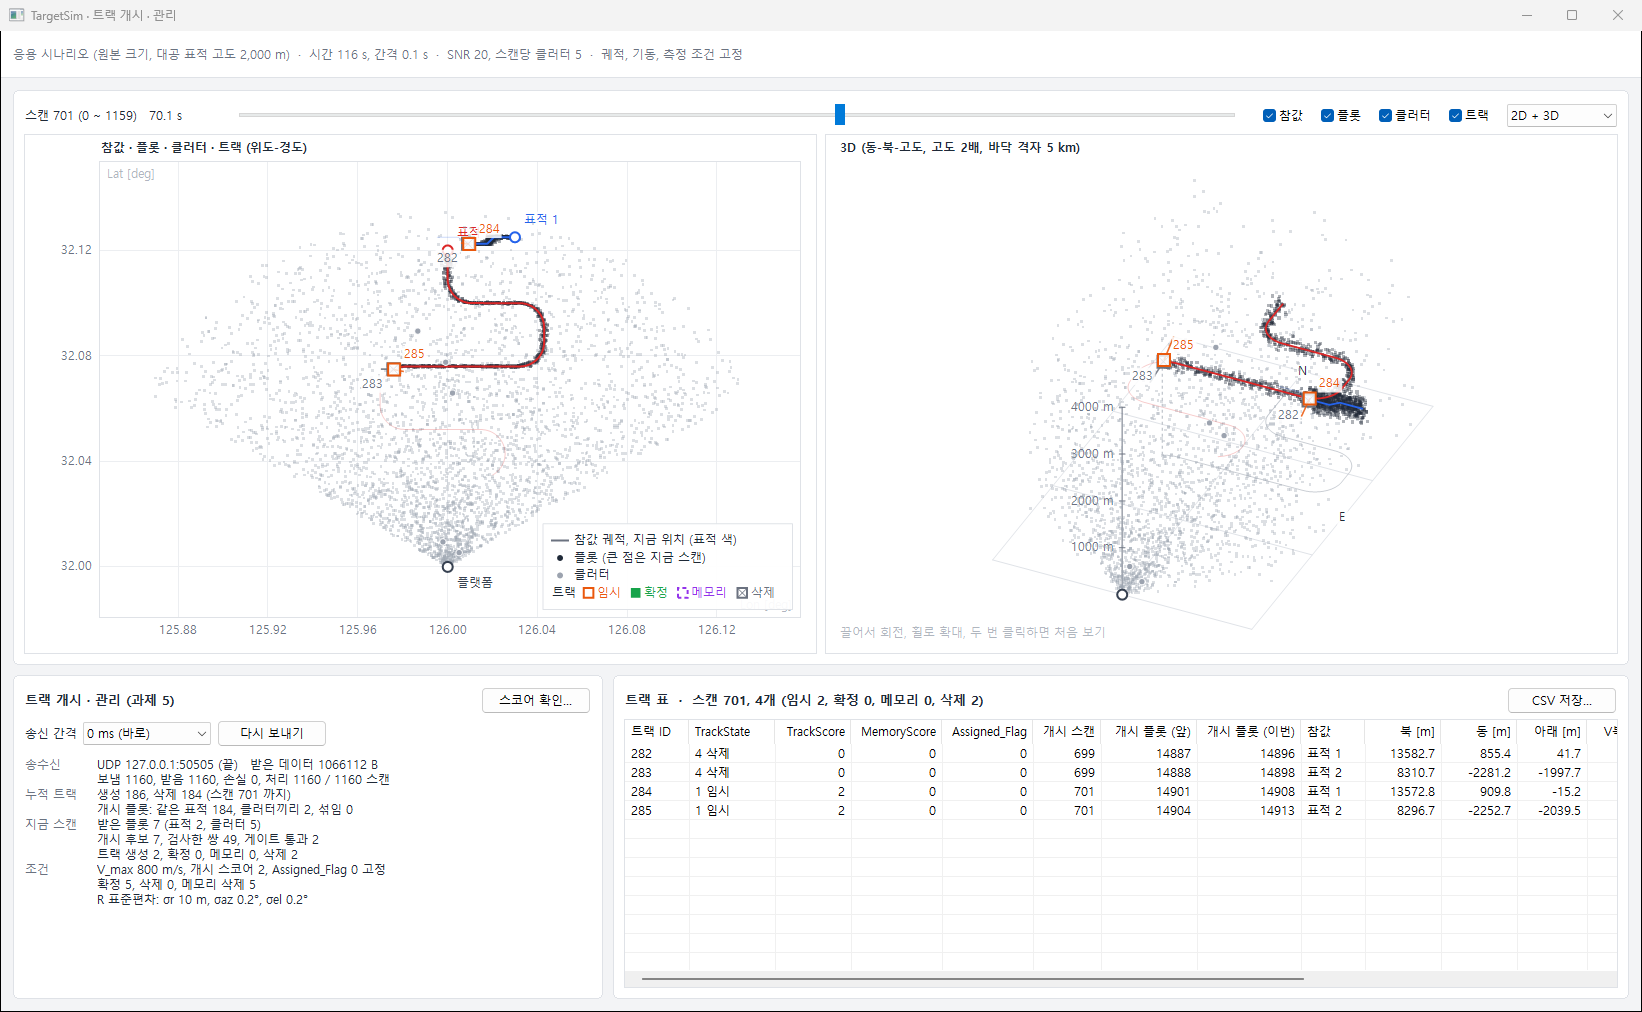 그림 10. 70.1 초 시점의 화면이다. 위는 2D 와 3D 보기, 왼쪽 아래는 송수신과 트랙 요약, 오른쪽 아래는 이 스캔의 트랙 표다. 네모가 트랙이고 옆 숫자가 트랙 ID 다.
2D 그림에서 진한 선은 지나온 참값 궤적, 옅은 선은 앞으로 지나갈 궤적이고 동그라미는 시작점이다. 작은 점이 플롯과 클러터고, 큰 점은 이번 스캔에 데이터 처리 쓰레드가 UDP 로 받은 플롯이다. 트랙 기호는 상태마다 다르다. 임시는 주황 네모, 확정은 초록으로 채운 네모, 메모리는 보라 점선 네모, 삭제는 회색 네모에 가위표다. 연관이 없는 이번 시뮬레이션에는 임시와 삭제만 나타난다. 네모에서 뻗은 짧은 선은 트랙의 추정 속도로 1 초 동안 가는 거리와 방향이다. 트랙의 위치는 플롯 하나의 오차만큼만 틀리지만 이 선의 길이와 방향은 2-Point 속도가 그대로 드러나는 자리라, 9절에서 보는 속도 오차를 화면에서 먼저 볼 수 있다. 요약 칸은 이 스캔까지 트랙 186 개가 생기고 184 개가 지워졌으며, 이번 스캔에는 플롯 일곱 개를 받아 마흔아홉 쌍을 검사해 두 쌍이 게이트를 지났고 트랙 둘이 생기고 둘이 삭제 상태가 됐다고 적는다.
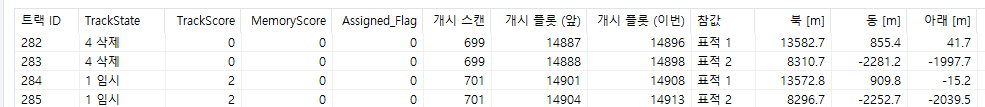 그림 11. 트랙 282 와 283 은 스캔 699 에 개시돼 점수가 0 이 된 삭제 트랙이고, 284 와 285 는 이번 스캔에 개시된 임시 트랙이다. 참값 열은 송신 쪽 기록을 화면이 꺼내 보인 것이다.
그림 11 의 트랙 282 와 284 가 어떻게 생겼는지는 표적 1 의 플롯을 스캔 순서로 늘어놓으면 보인다.
 그림 12. 위 줄은 표적 1 의 스캔별 플롯이고, 플롯 사이 선은 연속한 두 플롯이 80 m 게이트 안인지 밖인지다. 점선 구간은 앞 플롯이 이미 트랙에 쓰여 쌍을 검사하지 않은 자리다. 아래는 그 결과로 생긴 트랙 282, 284, 286 의 점수 변화다.
스캔 698 과 699 의 플롯은 29.8 m 떨어져 게이트를 지나 트랙 282 가 됐다. 699 의 플롯은 트랙에 쓰였으므로 700 의 플롯과는 짝을 검사하지 않는다. 700 과 701 은 57.3 m 로 통과해 트랙 284 가 됐다. 702 와 703 은 200.8 m, 703 과 704 는 139.3 m 로 게이트 밖이고, 704 와 705 가 62.5 m 로 다시 통과해 트랙 286 이 됐다. 그 사이 282 는 699·700·701 에 점수 2·1·0 으로, 284 는 701·702·703 에 2·1·0 으로 내려가 표에서 빠졌다. 701 과 702 의 플롯은 20.9 m 로 가장 가까웠지만 701 의 플롯이 이미 284 에 쓰였기 때문에 트랙이 되지 않았다. 한 플롯을 한 트랙에만 쓰는 규칙이 같은 표적의 다음 개시를 빨라야 두 스캔 뒤로 미루는 것이 이 자리다.
표적 2 가 레이다 가까이 온 스캔 1154 를 확대하면 트랙이 만들어지는 모양이 보인다.
 그림 13. 앞 스캔 플롯을 중심으로 반경 80 m 의 게이트 안에 이번 스캔 플롯이 들어와 트랙 451 이 생겼다. 두 스캔 전에 개시된 트랙 450 은 점수가 0 이 되어 삭제 상태다.
두 플롯 사이는 30.9 m 였다. 트랙 451 의 위치는 이번 플롯이고 속도는 30.9 m 를 0.1 초로 나눈 309 m/s 다. 참값 속력은 200 m/s 인데 플롯 잡음 때문에 100 m/s 넘게 차이가 난다. 트랙 450 은 스캔 1152 에 개시돼 점수가 2, 1, 0 으로 내려갔고 이 스캔에 삭제 상태가 됐다.
 그림 14. 트랙 100 부터 121 까지, 개시 시각 1.0 ~ 10.4 초의 22 개다. 줄 하나가 트랙 하나, 칸 하나가 스캔 하나다. 모든 트랙이 임시 두 스캔 뒤 삭제 한 스캔으로 끝난다. ID 색은 개시에 쓴 플롯이 어느 표적의 것인지를 뜻한다.
116 초 동안 트랙 355 개가 개시됐다. 개시에 쓴 플롯으로 나누면 표적 1 에서 117 개, 표적 2 에서 235 개, 클러터끼리 3 개다. 표적 플롯과 클러터가 섞여 트랙이 된 경우는 없었다. 353 개는 임시 두 스캔, 삭제 한 스캔의 세 줄을 남기고 표에서 빠졌고, 스캔 1158 에 개시된 두 개만 마지막 스캔에 점수 1 의 임시 상태로 남았다. 표에 동시에 있던 트랙은 많아야 네 개였다. 트랙 ID 는 100 부터 454, 플롯 ID 는 10000 부터 18119 까지 썼고 둘 다 처음 정한 범위 안이다.
ID 는 표적과 관계없이 만들어진 순서로 붙는다. 그림 14 에서 100 은 표적 2, 101 은 표적 1 의 트랙이다. 같은 표적에서 다음 트랙은 빨라야 두 스캔 뒤에 생긴다. 개시에 쓴 플롯을 다시 쓰지 않으므로 앞 트랙의 두 번째 플롯 다음 플롯부터 새 쌍이 가능하기 때문이다. 104 와 105 가 그 경우다. 실제로는 그보다 훨씬 드물게 생겼다. 표적 1 은 평균 9.8 스캔, 표적 2 는 평균 4.9 스캔마다 트랙이 하나씩 생겼다. 표적 2 는 다가올수록 자주 생겨서, 처음 10 초(스캔 0 ~ 99)에 11 개였던 것이 100 초부터 110 초 사이(스캔 1 000 ~ 1 099)에는 31 개였다. 왜 그런지는 9절에서 본다.
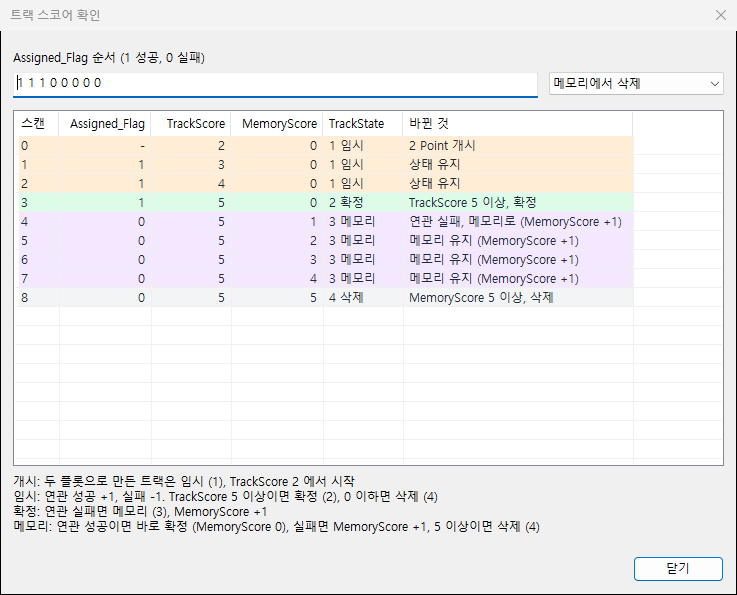 그림 15. Assigned_Flag 열을 넣으면 코어의 스코어 함수를 그대로 불러 스캔마다 점수와 상태를 표로 보인다. 1 1 1 0 0 0 0 0 을 넣은 경우로, 확정과 메모리를 거쳐 메모리 점수 5 에서 삭제된다.
연관이 없는 시뮬레이션에서는 확정과 메모리가 나타나지 않으므로 이 두 상태는 스코어 확인 창으로 확인했다. 창은 입력한 플래그 열로 7절의 스코어 함수를 그대로 돌리므로 시뮬레이션과 다른 코드가 아니다. 1 1 1 0 0 1 1 을 넣으면 메모리 상태의 여섯 번째 스캔에서 바로 확정으로 돌아가고 MemoryScore 가 0 으로 초기화되는 것도 같은 창에서 확인했다.
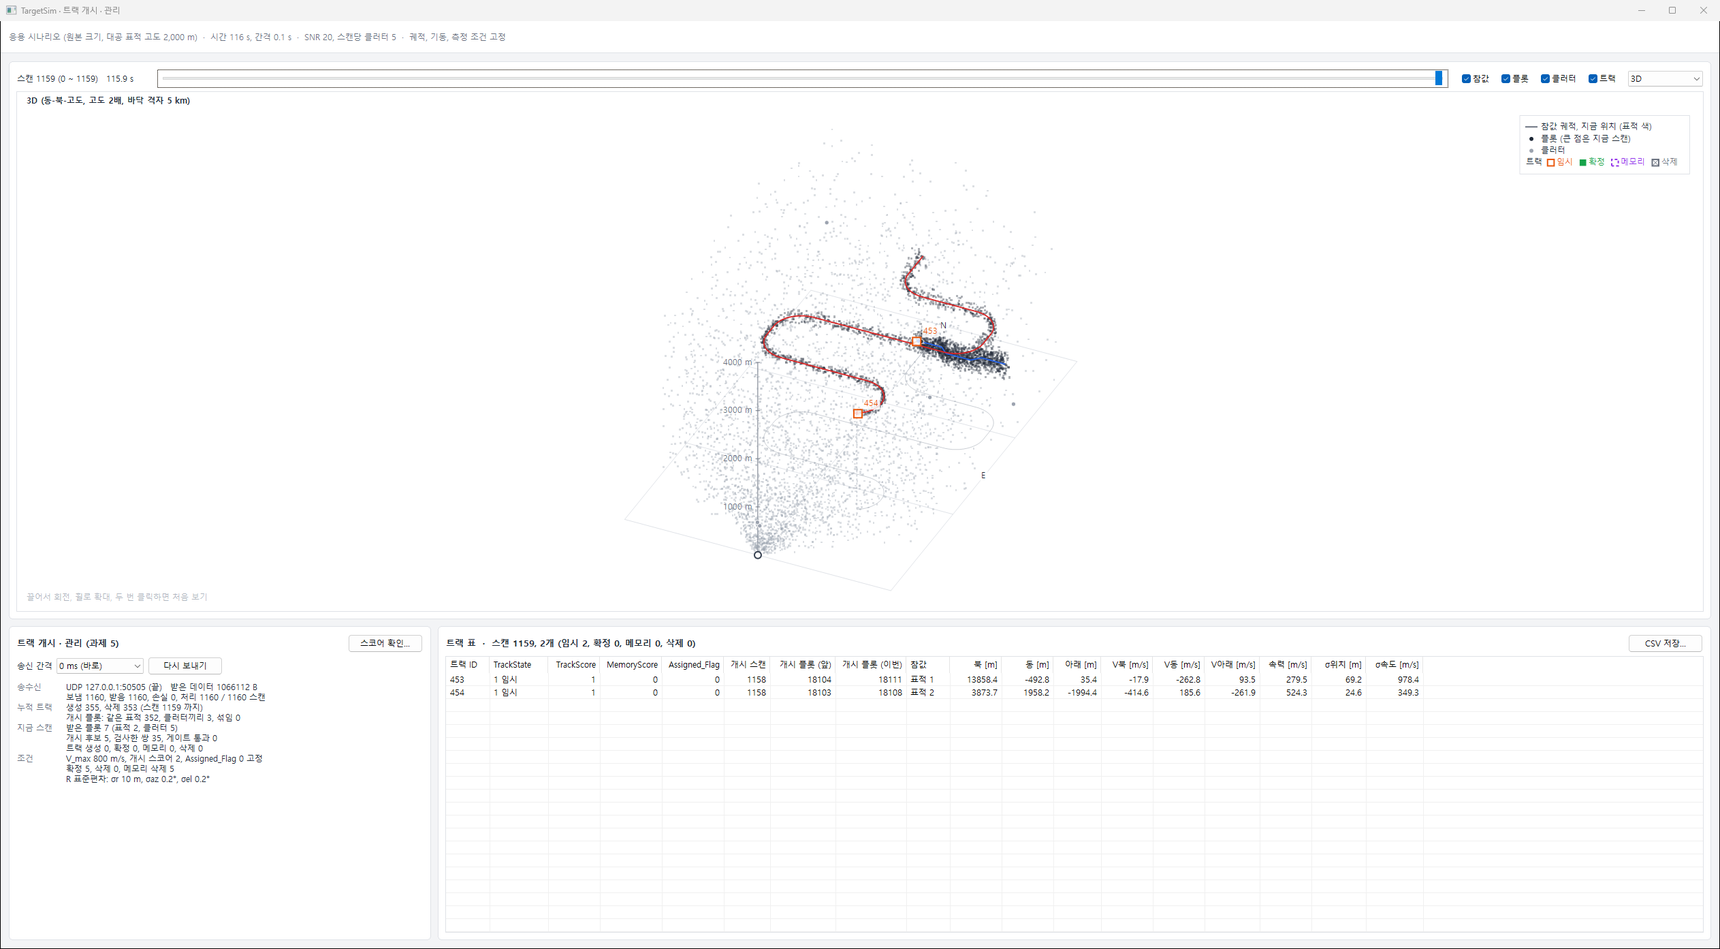 그림 16. 115.9 초, 마지막 스캔의 3D 보기다. 대공 표적은 고도 2 000 m 에서 S 자로 기동하며 다가왔고 대함 표적은 해수면에서 조금 움직였다. 궤적을 따라 붙은 점이 표적 플롯, 넓게 퍼진 회색 점이 클러터다.
마지막 스캔에 남은 트랙 453 과 454 의 속력은 각각 280 m/s 와 524 m/s 였다. 참값은 30 m/s 와 200 m/s 다. 트랙의 위치는 플롯 하나의 오차만큼 틀리지만 속도는 그보다 훨씬 크게 틀린다.
 그림 17. 스캔 1159 의 트랙 표다. 오른쪽 세 열이 속력과 초기 공분산에서 구한 위치·속도 표준편차다. 13.9 km 의 트랙 453 이 4.8 km 의 트랙 454 보다 위치는 2.8 배, 속도도 2.8 배 큰 표준편차를 가진다.
표의 표준편차 열은 공분산 대각 세 축을 제곱해 더한 뒤 제곱근을 취한 값이다. 트랙 453 은 위치 69.2 m, 속도 978 m/s, 트랙 454 는 24.6 m, 349 m/s 다. 두 트랙의 거리 비 2.9 에 거의 비례한다. 거리 성분 10 m 는 어디서나 같고 각도 성분만 거리에 비례하므로 비가 거리 비보다 조금 작다. 표적에서 멀수록 트랙이 자기 속도를 그만큼 덜 믿어야 한다는 것을 이 열이 필터에 전달한다.
프로그램과 별도로 코어 소스를 그대로 컴파일한 검증용 실행 파일에서 단위 시험도 돌렸다. 스코어 함수에 플래그 열을 넣어 상태 전이가 규칙과 같은지, 2-Point 초기화의 아홉 상태와 9 × 9 공분산이 식과 같은지, 속력 799 m/s 쌍은 트랙이 되고 801 m/s 쌍은 되지 않는지, 트랙 ID 가 9999 다음 10000 을 지나 100 으로 돌아오는지를 확인했다. 난수가 고정 시드라 검증용 실행과 화면 프로그램의 결과는 트랙 ID 와 위치까지 같다.
9. 결과 분석
여기까지가 구현한 범위다. 결과에는 처음 정한 조건이 그대로 만든 숫자가 몇 개 남아 있어서, 저장해 둔 플롯 8 120 개와 트랙 355 개로 그 숫자들이 어디서 왔는지 따져 보았다.
게이트와 측정 잡음
같은 표적에서 트랙이 5 ~ 10 스캔에 하나씩만 생긴 이유는 게이트가 측정 잡음보다 작기 때문이다. 플롯을 만든 잡음은 방위각 0.4781° 였다. 14 km 에서 가로 방향 117 m 다. 연속한 두 플롯의 차는 두 잡음의 차이므로 표준편차가 $\sqrt 2$ 배인 165 m 가 되고, 고각 방향도 같은 크기다. 이 차가 반경 80 m 안에 들 확률이 10 % 안팎이다. 그래서 표적 1 은 열 스캔에 한 번꼴로만 짝이 됐다.
| 거리 | 0.2° 의 가로 오차 | 0.4781° 의 가로 오차 | 두 플롯 차의 표준편차 |
|---|---|---|---|
| 5 km | 17 m | 42 m | 59 m |
| 10 km | 35 m | 83 m | 118 m |
| 14 km | 49 m | 117 m | 165 m |
표적 2 는 13.5 km 에서 4.8 km 까지 다가오므로 가까워질수록 잡음이 줄고 게이트를 더 자주 지난다. 저장한 플롯으로 같은 표적의 연속한 두 플롯 사이 거리를 전부 구해 80 m 안에 든 비율을 거리 구간마다 세고, 플롯 잡음의 표준편차로 두 플롯 차의 분포를 만들어 80 m 안에 들 확률을 계산한 곡선과 겹쳐 보았다.
 그림 18. 선은 플롯 잡음으로 계산한 확률이고 점은 시뮬레이션에서 센 비율이다. 5 km 에서 절반, 10 km 에서 다섯에 하나, 14 km 에서 열에 하나다. 표본이 50 쌍이 안 되는 구간인 표적 2 의 4 ~ 5 km 와 13 ~ 14 km 는 점을 찍지 않았다.
시뮬레이션 전체에서 표적 1 의 연속 플롯 쌍은 12.1 % 가 게이트를 지났고 계산 확률은 10.9 % 였다. 표적 2 는 27.1 % 와 28.8 % 다. 트랙이 생기는 간격은 이 비율의 역수인 8.3 스캔과 3.7 스캔보다 한 스캔 남짓 길어 9.8 스캔과 4.9 스캔이었다. 트랙을 만든 두 번째 플롯은 다음 스캔의 개시 후보에서 빠지므로 그 바로 다음 쌍은 검사하지 않기 때문이다. 실제로 검사한 쌍은 표적 1 이 1 042 개, 표적 2 가 924 개이고 그 가운데 117 개와 235 개가 지나 트랙이 됐다.
게이트를 키우면 표적 쌍은 더 지나지만 클러터 쌍도 더 지난다. 저장한 플롯으로 반경을 바꿔 가며 세어 보면 아래와 같다. 클러터 쌍은 연속한 두 스캔의 클러터 다섯 개씩을 전부 짝지은 28 975 쌍 가운데 반경 안에 든 쌍을 스캔당 개수로 적은 것이다.
| 게이트 반경 | 표적 1 쌍 통과 | 표적 2 쌍 통과 | 클러터 쌍 통과 (스캔당) |
|---|---|---|---|
| 80 m | 12 % | 27 % | 0.0026 |
| 150 m | 33 % | 64 % | 0.006 |
| 200 m | 52 % | 81 % | 0.013 |
| 300 m | 81 % | 96 % | 0.026 |
| 500 m | 99 % | 100 % | 0.089 |
| 1 000 m | 100 % | 100 % | 0.355 |
80 m 에서 클러터끼리 트랙이 된 것이 116 초 동안 3 개였다. 세 개가 생긴 자리는 모두 레이다에서 350 m 안이었다. 트랙 148 은 298 m, 161 은 249 m, 418 은 349 m 거리에서 개시됐다. 클러터 플롯 5 800 개 가운데 350 m 안에 있던 것은 49 개로 1 % 가 안 되는데 클러터 트랙은 전부 거기서 나왔다. 클러터를 거리 200 m ~ 15 km, 방위각 ±60°, 고각 0 ~ 30° 안에서 성분마다 균등하게 뽑으므로 단위 부피당 클러터 수는 거리의 제곱에 반비례하고, 300 m 와 7.5 km 를 견주면 625 배 차이가 난다. 반경이 거리와 무관하게 80 m 인 게이트에 연속한 두 스캔의 클러터가 함께 들어올 확률은 이 밀도에 비례하므로 가짜 트랙은 레이다 가까이에 모인다. 균등 모형으로 계산하면 연속한 두 클러터가 80 m 안에 들 확률은 쌍마다 $3 \times 10^{-5}$ 이고 116 초 동안의 기대값은 1 개 남짓이라, 3 개는 그보다 많지만 드문 일은 아니다.
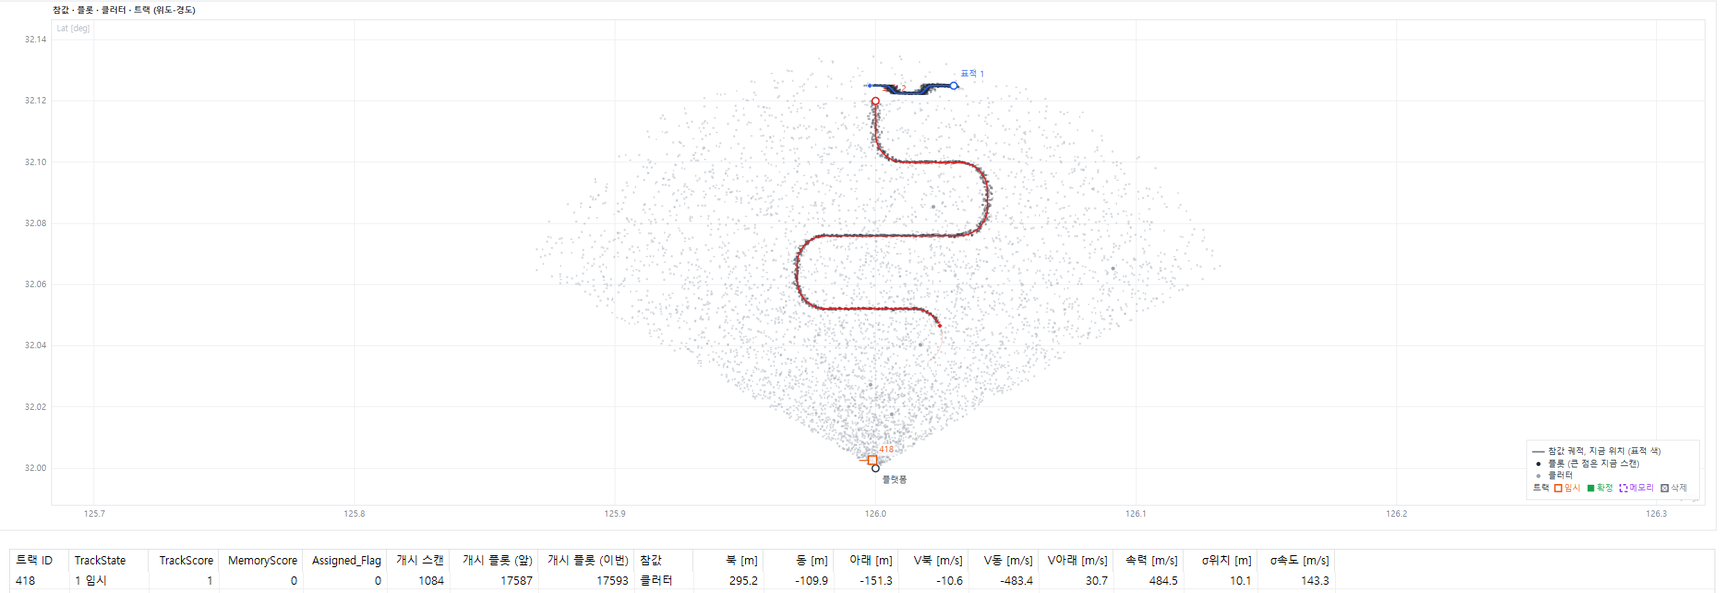 그림 19. 108.5 초의 2D 보기와 그 스캔의 트랙 표다. 스캔 1084 에 클러터 둘로 개시된 트랙 418 이 플랫폼 기호 바로 옆에 있다. 표의 참값 열이 클러터고 위치는 북 295 m, 동 −110 m, 아래 −151 m 로 레이다에서 349 m 다.
클러터끼리 트랙이 이만큼뿐인 것은 이 모의의 클러터가 스캔마다 서로 상관없이 새로 뽑히기 때문이기도 하다. 실제 레이다의 클러터는 다르다. 지형과 해면, 건물에서 오는 반사는 스캔마다 거의 같은 자리에 다시 나타난다. 두 스캔의 위치 차가 0 에 가까우니 최대 속도만 보는 게이트는 늘 지나고, 다음 스캔에도 같은 자리에 플롯이 있으니 연관도 성공해 스코어 규칙이 그 트랙을 확정시킨다. 그래서 실제 체계의 개시 게이트는 최대 속도 위만 자르지 않고 최소 속도 $V_{min}$ 아래도 잘라 $V_{min} < \lvert z_k - z_{k-1} \rvert / T < V_{max}$ 의 구 껍질 모양으로 두거나, 도플러가 0 근처인 플롯을 개시에서 빼거나, 자리마다 탐지가 반복되는 정도를 기록한 클러터 맵으로 그 자리의 플롯을 거른다. 대함 표적처럼 30 m/s 로 느린 표적을 살리려면 $V_{min}$ 은 그보다 낮아야 하므로, 느린 표적과 고정 클러터의 구분은 도플러와 클러터 맵이 맡는다.
반경을 300 m 로 늘리면 표적 쌍은 거의 다 지나면서 클러터 트랙은 10 배인 30 개 정도가 생긴다. 어느 쪽이 나은지는 뒤에 오는 관리 규칙이 가짜 트랙을 얼마나 잘 지우느냐에 달려 있다. 최대 속도만으로 정한 게이트는 잡음이 작은 가까운 표적에는 맞지만 먼 표적에는 너무 좁다. 게이트는 표적의 최대 이동량에 측정 잡음을 더한 크기로 잡아야 하고, 그 잡음이 거리에 따라 변하므로 게이트도 플롯마다 달라야 한다. 두 플롯의 공분산을 더한 행렬로 차이를 정규화해 카이제곱 문턱과 비교하는 것이 그 방법이고, 이 R 을 플롯마다 이미 계산하고 있으므로 그대로 쓸 수 있다.
2-Point 속도의 신뢰도
트랙 451 의 속력 309 m/s, 트랙 453 의 280 m/s, 트랙 454 의 524 m/s 는 참값 200, 30, 200 m/s 와 크게 다르다. 우연이 아니라 식이 그렇게 만든다. 위치 표준편차 $\sigma_p$ 인 플롯 둘로 속도를 만들면 속도 표준편차는 아래와 같다.
\[\sigma_v = \frac{\sqrt 2\,\sigma_p}{T}\]14 km 에서 가로 방향 $\sigma_p$ 가 117 m 이고 $T$ 가 0.1 초이므로 $\sigma_v$ 는 1 650 m/s 다. 표적이 0.1 초 동안 실제로 움직이는 거리는 표적 1 이 3 m, 표적 2 가 20 m 인데, 두 플롯 차의 표준편차 165 m 는 표적 2 의 이동량의 여덟 배, 표적 1 의 이동량의 쉰 배가 넘는다. 그래서 2-Point 속도는 표적의 움직임이 아니라 잡음의 차를 재는 것에 가깝다. 실제로 표적 1 에서 생긴 트랙 117 개의 속력 추정값은 평균 554 m/s, 최대 793 m/s 였고 100 m/s 아래는 하나도 없었다. 표적 2 의 트랙 235 개는 평균 536 m/s 였다. 모든 트랙을 통틀어 속도 오차의 RMS 는 575 m/s 다. 추정값이 800 m/s 를 넘지 않는 것은 게이트가 그 위를 잘라 냈기 때문이지 추정이 좋아서가 아니다.
이것이 2-Point 개시의 한계다. 스캔 간격이 짧고 각도 잡음이 클수록 속도는 못 쓰게 된다. 2-Point 로 만든 초기 속도는 추적 필터가 여러 스캔을 거치며 고쳐 나가야 할 초기값이지 그대로 쓸 값이 아니다. 초기 공분산의 속도 칸이 수백 m/s 로 큰 것은 바로 그 사실을 필터에 알리는 역할을 한다. 공분산이 크면 필터는 첫 몇 스캔 동안 예측보다 측정을 믿고, 그 사이에 속도가 참값 쪽으로 빠르게 잡힌다. 간격이 긴 두 스캔을 쓰거나 세 점 이상으로 개시하면 속도 오차가 줄지만 개시가 그만큼 늦어진다.
속도를 모른다고 0 으로 두는 1-Point 개시의 속도 오차는 표적의 실제 속력 그대로 30 m/s 와 200 m/s 다. 2-Point 로 만든 352 개 트랙의 속도 오차 RMS 는 575 m/s 다. 이 시나리오에서는 두 플롯으로 속도를 만든 쪽이 모른다고 둔 쪽보다 세 배에서 스무 배 나쁘다. 1-Point 개시에서 속도 칸의 공분산은 표적이 낼 수 있는 최대 속력으로 잡는다. 속도가 반경 $V_{max}$ 의 구 안에 고르게 있다고 보면 축마다 분산이 $V_{max}^2/5$ 이고 800 m/s 면 표준편차 358 m/s 다. 2-Point 의 축당 속도 표준편차 $\sqrt 2\,\sigma_p/T$ 가 이보다 작아야 두 번째 플롯을 기다린 보람이 있고, 그 조건은 $T > \sqrt{10}\,\sigma_p/V_{max}$ 다. 거리 방향은 $\sigma_p$ 가 4.74 m 라 $T$ 가 0.02 초만 넘으면 되지만, 14 km 의 가로 방향은 $\sigma_p$ 가 117 m 라 0.46 초가 필요하고 초기화에 쓴 0.2° 로 계산해도 0.18 초다. 스캔 간격 0.1 초는 가로 방향에서 이 조건을 만족하지 못한다. 2-Point 는 거리 방향 속도만 믿을 만하고 가로 방향 속도는 1-Point 의 사전 분산보다 나쁘다. 스캔 간격이 짧은 체계에서는 한 스캔을 건너뛴 두 플롯로 개시하거나, 세 플롯 이상을 최소제곱으로 맞추거나, 가로 방향 속도 칸만 $V_{max}^2/5$ 로 두는 쪽이 낫다.
초기 공분산의 일관성
공분산은 추정값이 얼마나 틀릴 수 있는지를 적은 것이므로 실제 오차와 크기가 맞아야 한다. 맞는지 보는 수단이 정규화 추정 오차 제곱(NEES, normalized estimation error squared)이다. 추정 오차 $\tilde x$ 를 공분산으로 나눈 값으로, 공분산이 맞으면 평균이 상태의 차원과 같다.
\[\epsilon = \tilde x^T P^{-1} \tilde x, \qquad E[\epsilon] = 6\]위치와 속도 여섯 개 상태로 표적 트랙 352 개의 초기 오차를 참값과 비교해 계산했다. 초기화에 쓴 0.2° 로 만든 공분산에서는 평균이 15.1 이다. 기대값 6 의 2.5 배로, 공분산이 실제 오차보다 작다는 뜻이다. 플롯을 만든 잡음 0.4781° 로 공분산을 다시 만들면 평균이 4.5 가 되어 기대값에 가깝다. 6 보다 조금 작은 것은 게이트가 오차가 큰 쌍을 걸러 냈기 때문이다. 각도 표준편차의 비 0.4781 / 0.2 를 제곱하면 5.7 이라 가로 방향 칸은 그만큼 작게 적혀 있다. 평균이 6 에서 얼마나 벗어나야 틀렸다고 할 수 있는지는 표본 수로 정해진다. 6 자유도 카이제곱 변수 352 개의 평균은 공분산이 맞을 때 95 % 확률로 5.64 와 6.36 사이에 있다. 15.1 은 이 구간에서 멀리 벗어나 있고 4.5 도 벗어나 있다. 4.5 가 게이트 때문인지는 게이트를 치우고 확인할 수 있다. 저장한 플롯으로 같은 표적의 연속한 두 플롯 쌍 2 316 개 전부에 같은 계산을 하면, 실제 잡음으로 만든 공분산의 NEES 평균은 6.11 로 구간 5.86 ~ 6.14 안에 들어오고 0.2° 로 만든 공분산은 24.3 이 된다. 게이트가 오차 큰 쌍을 잘라 낸 352 개만 보면 4.5 로 내려가는 것이다.
받는 쪽이 전달받은 정확도가 실제 잡음과 다르면 공분산은 틀린 값이 되고, 그 위에 올라가는 필터는 자신을 과신한다. 공분산이 작으면 필터는 측정을 덜 믿고 예측을 더 믿어 수렴이 느려지고, 연관 게이트도 작아져 표적 플롯을 놓치기 쉬워진다. 메시지의 표준편차 칸은 레이다가 그 플롯을 실제로 잰 정확도를 담아야 하고, 정확도가 SNR 에 따라 변하므로 플롯마다 달라야 한다. 플롯마다 그 값을 주는 식은 14장 2절에 있고, 여기서 고정값을 쓴 것은 처음에 그렇게 정해 두었기 때문이다.
스코어 규칙의 통계
개시 2, 확정 5, 삭제 0 의 스코어 규칙은 성공 세 번이 실패 두 번보다 먼저 쌓여야 확정된다는 뜻이다. 스캔마다 연관에 성공할 확률을 $p$ 라 하고 실패 확률을 $q = 1 - p$ 라 하면, 점수 2 에서 출발해 0 보다 5 에 먼저 닿을 확률은 두 흡수 벽 사이의 임의 보행 문제가 되어 닫힌 식으로 나온다.
\[P_{confirm} = \frac{1 - (q/p)^2}{1 - (q/p)^5}\]개시 점수는 따로 정해 둔 것이 없어 2 로 두었는데 이 값이 확정 확률을 크게 바꾼다. 같은 식에서 출발점만 바꾸면 결과는 아래와 같다.
| 개시 점수 | 연관 확률 0.9 인 표적의 확정 확률 | 연관 확률 0.3 인 가짜 트랙의 확정 확률 |
|---|---|---|
| 1 | 88.9 % | 2.0 % |
| 2 | 98.8 % | 6.5 % |
| 3 | 99.9 % | 17.2 % |
개시 점수 1 은 첫 스캔을 한 번만 놓쳐도 바로 지워지므로 진짜 표적의 11 % 를 잃고, 3 은 가짜 트랙을 세 배 가까이 더 살린다. 2 는 두 플롯으로 성공 두 번을 쳐 준 값이면서 이 둘 사이에 있다.
 그림 20. 실선이 스코어 규칙, 점선이 5 번 중 3 번 확정에 3 번 연속 실패 삭제인 M/N 규칙이다. 오른쪽 표는 확정 또는 삭제가 나기까지 평균 몇 스캔이 걸리는지다.
탐지 확률 0.9 인 표적이면 98.8 % 가 확정되고, 판정까지 평균 3.7 스캔이 걸린다. 클러터로 만들어진 가짜 트랙은 다음 스캔에 또 클러터가 연관 게이트에 들어올 확률이 $p$ 인데, 이 값은 게이트 부피 $V_G$ 와 클러터 밀도 $\beta$ 로 $p = 1 - e^{-\beta V_G}$ 로 정해진다. 6절에서 본 혁신 공분산 $6R$ 의 99 % 타원 게이트는 14 km 에서 부피가 $1.6 \times 10^8$ m³ 로 80 m 구의 74 배지만, 이 모의의 클러터는 그 거리에서 밀도가 $1.6 \times 10^{-12}$ /m³ 라 게이트 안 기대 개수가 0.00025 개다. 저장한 플롯으로 세어도 앞 스캔 클러터 플롯에서 반경 200 m 안에 다음 스캔 클러터가 들어올 확률이 0.003, 1 km 로 넓혀도 0.06 이다. 예로 드는 $p = 0.3$ 은 이 밀도의 천 배가 넘는 환경, 이 FOV 에 스캔당 클러터 7 000 개쯤이 고르게 깔린 경우에 해당한다. 그 경우 6.5 % 만 확정되고 평균 4.2 스캔 안에 대부분 지워진다. 같은 조건에서 M/N 규칙은 25.7 % 를 확정한다. 창 안에서 세기만 하고 실패를 빼지 않으므로 더 쉽게 확정하고, 그만큼 가짜 트랙도 더 많이 살린다. 반대로 탐지 확률이 낮은 표적은 M/N 쪽이 더 잘 살린다. 두 규칙은 가짜 트랙의 확정률과 진짜 트랙의 확정 속도를 함께 정하므로, 가짜 트랙을 덜 확정하도록 문턱을 두면 진짜 트랙의 확정도 그만큼 늦어진다.
메모리 삭제 문턱 5 는 확정 트랙이 다섯 스캔, 0.5 초 동안 놓쳐도 지우지 않고 기다린다는 뜻이다. 탐지 확률 0.9 에서 다섯 번 연속 놓칠 확률은 $0.1^5$ 으로 십만 분의 일이라 진짜 표적을 잘못 지우는 일은 거의 없다. 대신 확정까지 간 가짜 트랙은 다섯 스캔을 더 산다. 이 ±1 점수는 연관 성공과 실패의 우도비에 로그를 씌운 값을 모든 스캔에서 같은 크기로 둔 것이고, 탐지 확률과 클러터 밀도와 게이트 크기로 스캔마다 다른 크기를 매기면 그것이 순차 확률비 검정(SPRT) 꼴의 트랙 스코어가 된다. 문턱 5 와 0 은 그때 허용할 오경보와 미탐지 확률에서 역산하는 값이다.
10. 정리
플롯을 트랙으로 바꾸는 첫 단계를 구현했다. 송신 쓰레드가 스캔마다 표적 플롯과 클러터를 섞어 플롯 메시지로 보내고, 수신 쓰레드가 받아 좌표를 바꾸고 플롯마다 측정잡음 공분산을 만든 뒤 트랙을 개시하고 관리한다. 개시는 연속한 두 플롯을 80 m 속도 게이트로 짝지어 위치는 이번 플롯, 속도는 위치 차를 시간 차로 나눈 값, 가속도는 0 으로 두고, 공분산은 $R_k$, $R_k / T$, $(R_k + R_{k-1}) / T^2$ 으로 채운다. 관리는 연관 성공에 +1, 실패에 −1 을 주어 5 에서 확정하고 0 에서 삭제하며, 메모리 점수 5 에서 메모리 트랙을 삭제한다.
116 초 동안 트랙 355 개가 생겼고 연관이 없어 모두 두 스캔 뒤 삭제됐다. 표적 트랙이 5 ~ 10 스캔에 하나씩만 생긴 것은 80 m 게이트가 먼 표적의 측정 잡음보다 작기 때문이고, 트랙의 초기 속도가 참값과 수백 m/s 어긋난 것은 0.1 초 간격의 두 플롯 차로 속도를 만든 결과다. 초기화에 쓴 0.2° 로 만든 초기 공분산은 실제 오차보다 작아 NEES 가 기대값의 2.5 배였고, 플롯을 만든 잡음으로 만들면 기대값에 맞았다. 게이트는 측정 잡음을 포함해 플롯마다 잡아야 하고, 메시지에 실어 보내는 정확도는 실제 잡음과 같아야 하며, 2-Point 속도는 필터가 고쳐 나갈 초기값으로 봐야 한다.
참고 자료
- S. S. Blackman, R. Popoli, Design and Analysis of Modern Tracking Systems, Artech House — 트랙 개시와 확정·삭제 논리, M/N 규칙과 트랙 스코어 규칙, 우도비에 기초한 스코어 함수와 순차 확률비 검정
- Y. Bar-Shalom, X. R. Li, T. Kirubarajan, Estimation with Applications to Tracking and Navigation, Wiley — 두 측정치의 차분으로 초기 상태와 공분산을 만드는 2-Point 초기화, 측정 공분산의 좌표 변환, 게이팅, NEES 로 필터 일관성을 확인하는 방법
- Y. Bar-Shalom, P. K. Willett, X. Tian, Tracking and Data Fusion: A Handbook of Algorithms, YBS Publishing — 트랙 개시 논리와 가짜 트랙 확정 확률, 연관 게이트의 카이제곱 문턱
- W. Feller, An Introduction to Probability Theory and Its Applications, Vol. 1, Wiley — 두 흡수 벽 사이 임의 보행의 흡수 확률과 평균 흡수 시간